結論
- jq に渡す
.や.branchのような式をフィルタと呼ぶ。jq の入力は「JSON 値の並び」で、フィルタは値ごとに動く。連結した JSON は値の数だけ結果を出し、壊れた箇所の手前の値は、終了コード 5 で失敗しても stdout に出る。1 値だけを受けるなら-sで全体を読み、length == 1と型を確かめる -sは全部を読めてから配列を作るので、1 行でも壊れた JSON Lines (1 行に 1 つの JSON を書く形式) では何も出さない。壊れた行だけを捨てるなら-Rとfromjson?を使う- 偽になるのは
falseとnullだけで、0・""・[]は真、無い項目はnullになる。//はfalseも右辺に置き換える。フラグの判定は真偽でなく== falseや> 0の比較で書く - ツリーを辿る
recurse(.children[])はchildrenの無いノードで止まるので、エラーを捨てる?を付ける。祖先の条件を子孫に効かせるなら、後段のselect(条件が真の値だけを残す関数) でなくrecurse(f; cond)に書く - シェルとの境目では値の形が変わる。
@tsvは\を二重にし、IFS=$'\t' readは空の列を詰め、--arg(シェルの値を jq の変数に渡すオプション) の値は 1 個 128 KiB までしか渡せない。1 件ごとに jq を起動すると、jq 1 回で全件を出す形より桁で遅い
以下は jq 1.8.2 / GNU bash 5.3.20 / Linux x86_64 で実測した。出力の rc= は echo "rc=$?" で出した終了コードで、stderr のエラー文が stdout より先に並ぶのは、パイプへの stdout がバッファされ、終了時に書かれるためである。
連結した JSON は値ごとに処理され、壊れた箇所の手前の値は出力される
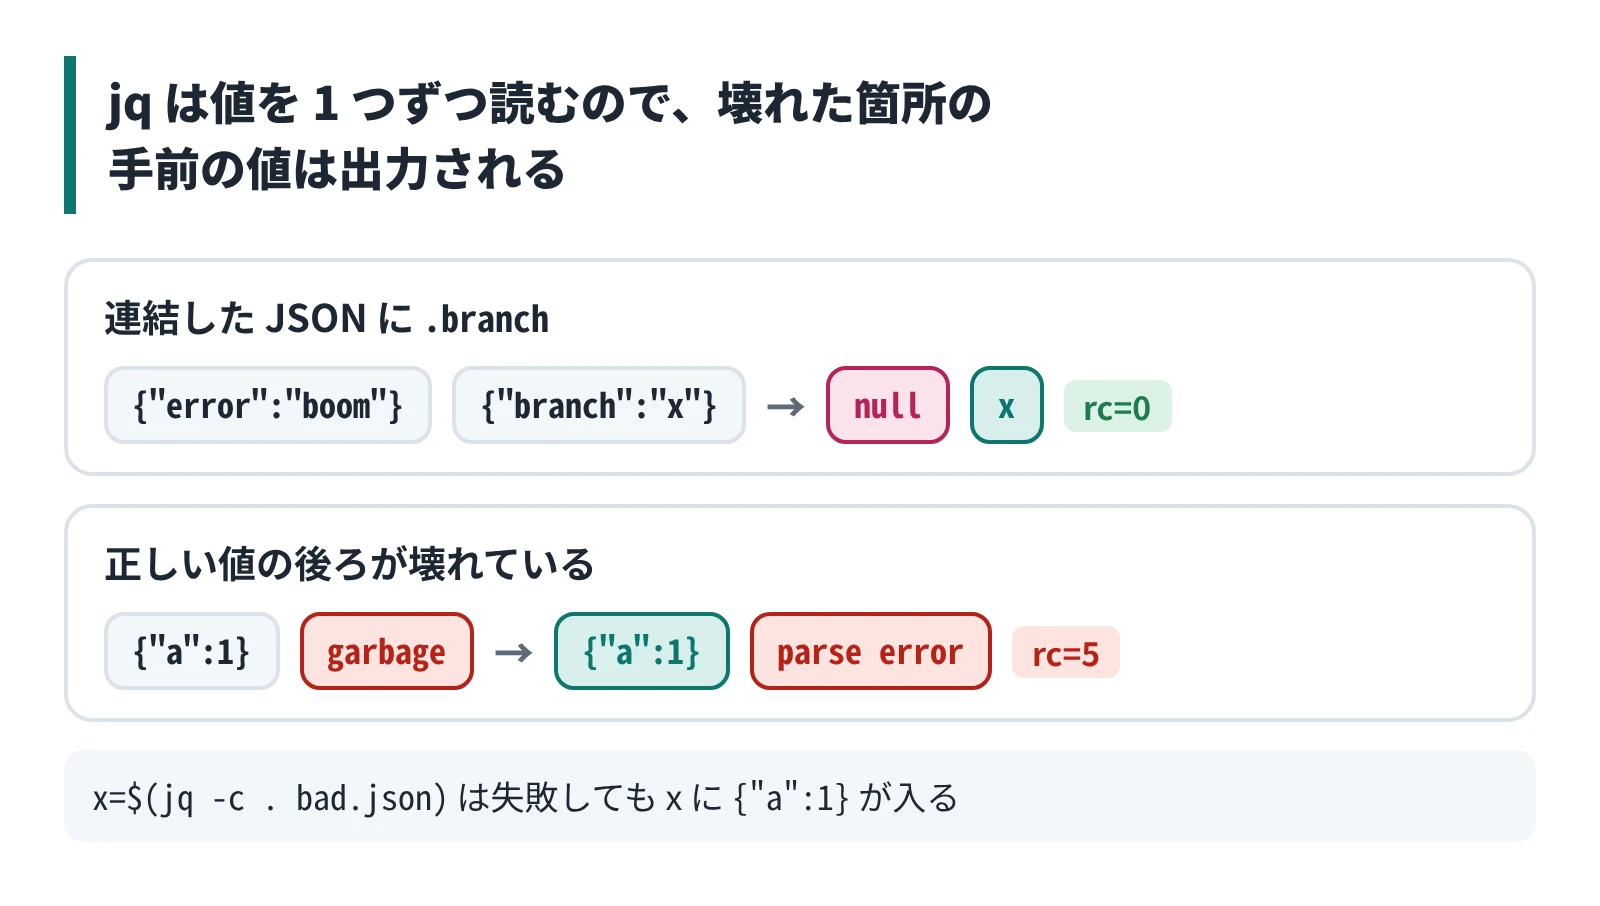
jq は 1 つの入力に複数の JSON 値があってよい作りで、先頭から 1 値ずつ読み、読めた値から順にフィルタへ流す。連結した JSON はエラーにならず、値の数だけ結果が出る。
$ printf '{"a":1}{"b":2}' | jq -c .; echo "rc=$?"
{"a":1}
{"b":2}
rc=0
$ printf '{"error":"boom"}{"branch":"x"}' | jq -r .branch; echo "rc=$?"
null
x
rc=0
2 つ目の例のように、1 値のつもりで受けた出力が 2 行になり、終了コードは 0 のままになる。シェルの文字列比較で null を弾こうとしても、値は null と x の 2 行なので一致しない。
$ v=$(printf '{"error":"boom"}{"branch":"x"}' | jq -r .branch); [[ $v == null ]] && echo 'null と判定' || echo "null でないと判定: [$v]"
null でないと判定: [null
x]
正しい値の後ろが壊れていると、jq は先頭の値を処理して出力したあと、壊れた箇所に達して終了コード 5 で失敗する。$(...) で受けると、失敗した上で変数に先頭の値が入る。
$ printf '{"a":1} garbage' > bad.json
$ jq -c . bad.json; echo "rc=$?"
jq: parse error: Invalid numeric literal at EOF at line 1, column 15
{"a":1}
rc=5
$ x=$(jq -c . bad.json); echo "rc=$? x=$x"
jq: parse error: Invalid numeric literal at EOF at line 1, column 15
rc=5 x={"a":1}
1 つの値だけを受けたいときは、-s で全体を読んでから 1 値かどうかを見る。-s は全部を読めてから動くので、壊れた入力では何も出さない。
$ jq -s -c 'if length == 1 then .[0] else error("not a single value") end' bad.json; echo "rc=$?"
jq: parse error: Invalid numeric literal at EOF at line 1, column 15
rc=5
$ printf '{"a":1}{"b":2}' | jq -s -c 'if length == 1 then .[0] else error("not a single value") end'; echo "rc=$?"
jq: error (at <stdin>:0): not a single value
rc=5
$ printf '{"a":1}' | jq -s -c 'if length == 1 then .[0] else error("not a single value") end'; echo "rc=$?"
{"a":1}
rc=0
取り出す値の検査も、シェルの文字列でなく jq の型で行う。-e は最後の出力が false か null のときに終了コード 1 を返す。型で見るので、文字列の中の null は弾かない。
$ printf '{"branch":"null チェック"}' | jq -e -s 'length == 1 and (.[0] | type == "object") and (.[0].branch | type == "string" and length > 0)' >/dev/null; echo "rc=$?"
rc=0
$ printf '{"branch":null}' | jq -e -s 'length == 1 and (.[0] | type == "object") and (.[0].branch | type == "string" and length > 0)' >/dev/null; echo "rc=$?"
rc=1
$ printf '{"error":"boom"}{"branch":"x"}' | jq -e -s 'length == 1 and (.[0] | type == "object") and (.[0].branch | type == "string" and length > 0)' >/dev/null; echo "rc=$?"
rc=1
PITFALL: 終了コードを見ないと、壊れた入力の先頭の値だけが後続の処理に渡る。
JSON Lines の 1 行が壊れると、-s は何も出さない
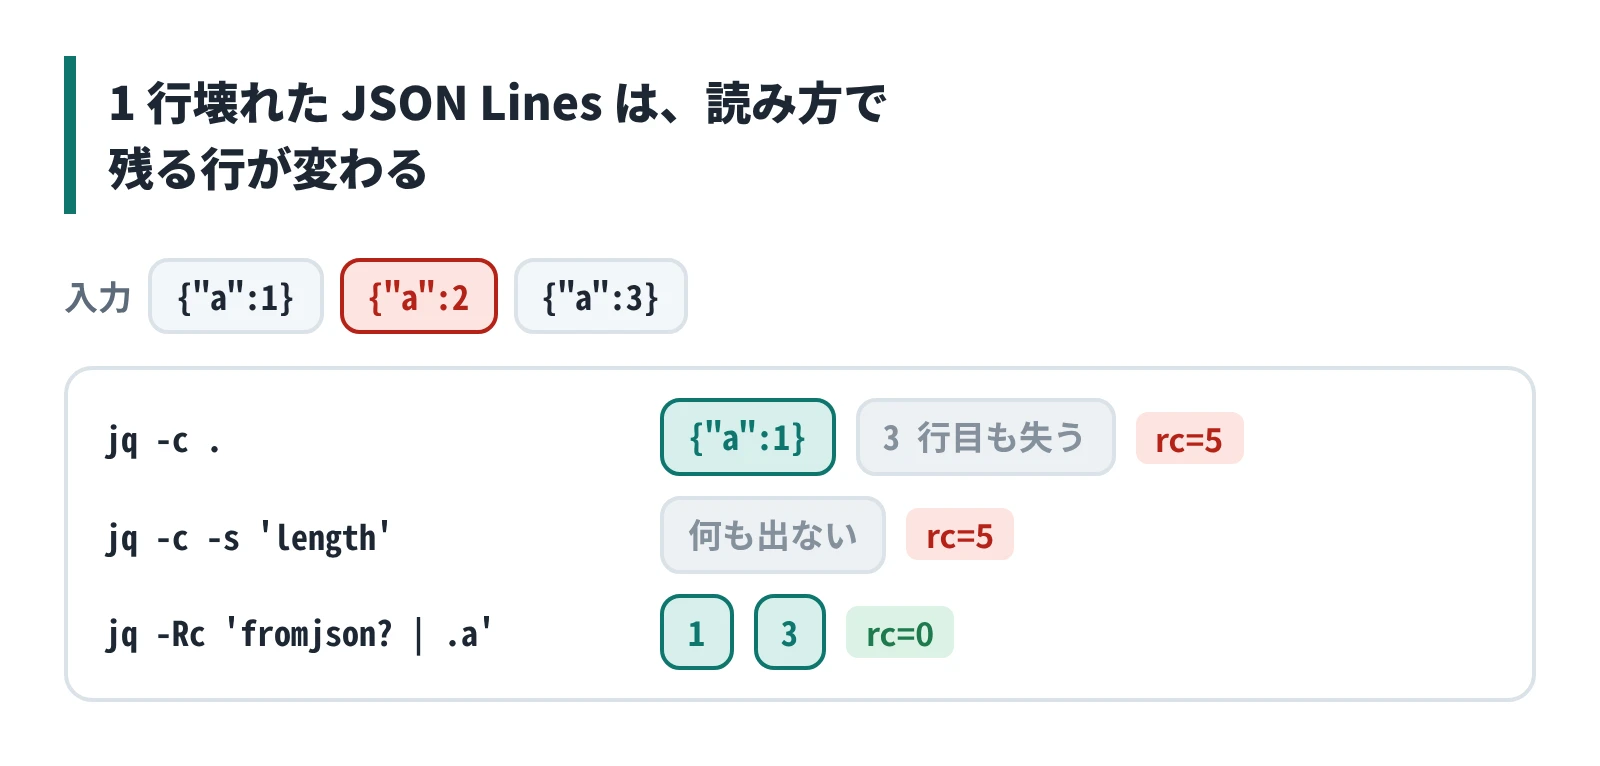
-s は読んだ値を全部まとめて 1 つの配列にする。配列ができるのは全部を読めた後なので、途中に 1 か所でも壊れた箇所があると、フィルタは 1 度も動かない。-R は各行を文字列として読み、fromjson? は変換に失敗した行で何も出さない。この組なら壊れた行だけが落ちる。
$ printf '{"a":1}\n{"a":2\n{"a":3}\n' > mid.jsonl
$ jq -c . mid.jsonl; echo "rc=$?"
jq: parse error: Expected separator between values at line 3, column 1
{"a":1}
rc=5
$ jq -c -s 'length' mid.jsonl; echo "rc=$?"
jq: parse error: Expected separator between values at line 3, column 1
rc=5
$ jq -Rc 'fromjson? | .a' mid.jsonl; echo "rc=$?"
1
3
rc=0
-R なしの jq は、閉じていない {"a":2 の続きとして次の行を読むので、3 行目の {"a":3} も失う。追記の途中で末尾の行が切れているファイルも同じで、-s は 0 件、fromjson? は完全な行だけを返す。
$ printf '{"a":1}\n{"a":2}\n{"a":3' > tail.jsonl
$ jq -c -s 'length' tail.jsonl; echo "rc=$?"
jq: parse error: Unfinished JSON term at EOF at line 3, column 6
rc=5
$ jq -Rc 'fromjson? | .a' tail.jsonl; echo "rc=$?"
1
2
rc=0
PITFALL: 2>/dev/null でエラーを捨てると、「壊れていた」と「該当なし」が同じ空の出力になる。
偽は false と null だけで、無い項目は null になる
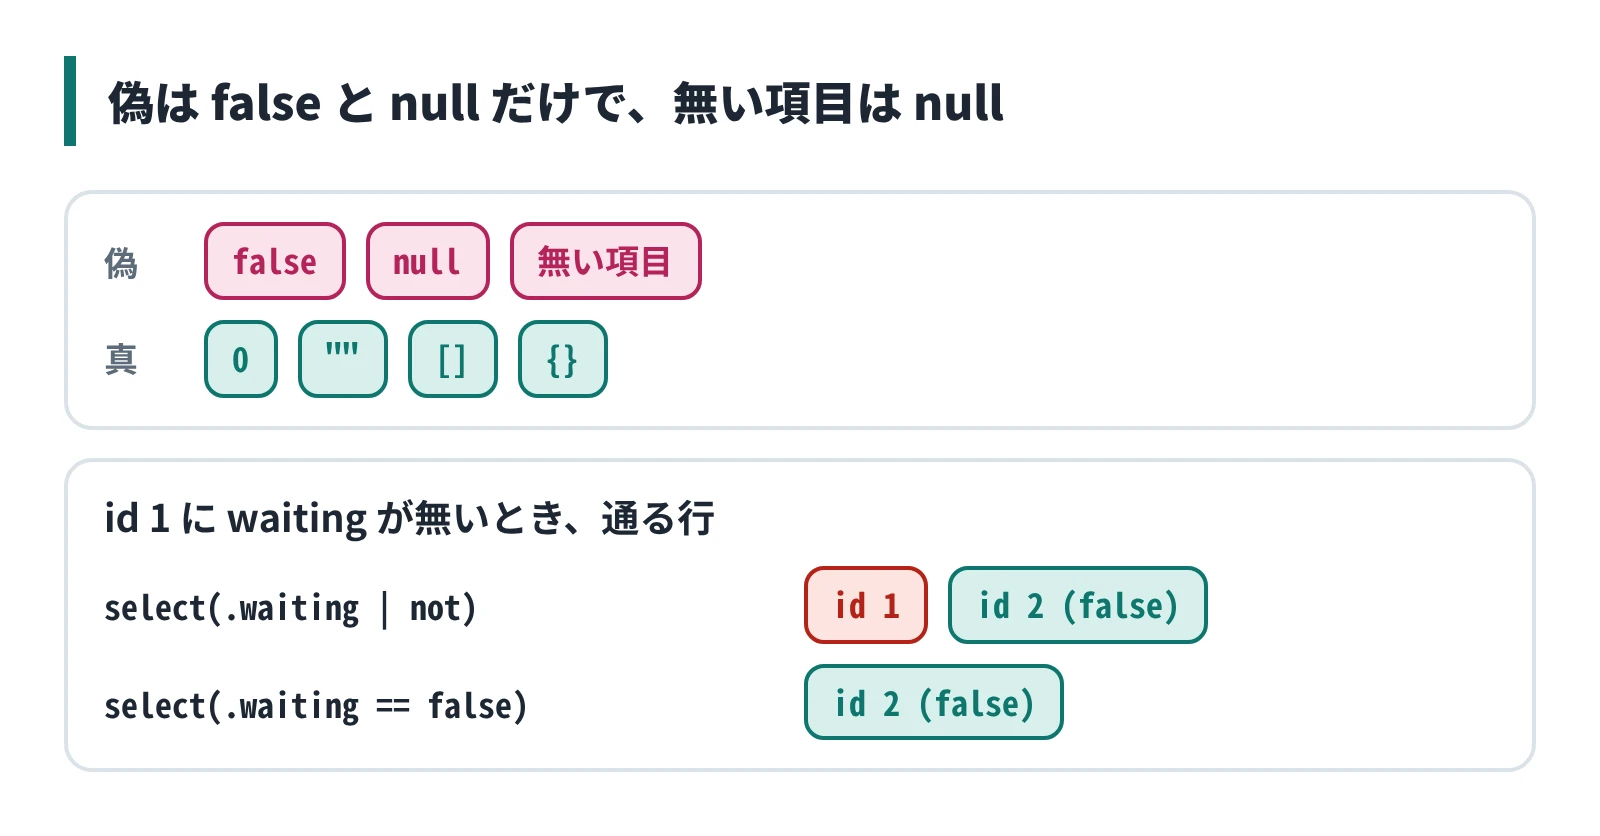
jq の条件式で偽になるのは false と null の 2 つだけで、JavaScript と違い 0・""・[] は真になる。
$ echo '[false,null,0,"",[],{}]' | jq -c '.[] | {v: ., truthy: (if . then true else false end)}'
{"v":false,"truthy":false}
{"v":null,"truthy":false}
{"v":0,"truthy":true}
{"v":"","truthy":true}
{"v":[],"truthy":true}
{"v":{},"truthy":true}
select(条件) は、条件が真の値だけを残し、偽の値を捨てる関数である。無い項目を読むと null になるので、not で反転すると「項目が無い」も残る。空配列は真なので、select(.blocked) は空の blocked も通す。
$ echo '[{"id":1},{"id":2,"waiting":false},{"id":3,"waiting":true}]' > w.json
$ jq -c '.[] | select(.waiting | not)' w.json
{"id":1}
{"id":2,"waiting":false}
$ jq -c '.[] | select(.waiting == false)' w.json
{"id":2,"waiting":false}
$ echo '[{"id":1,"blocked":[]},{"id":2,"blocked":["x"]},{"id":3}]' > b.json
$ jq -c '.[] | select(.blocked)' b.json
{"id":1,"blocked":[]}
{"id":2,"blocked":["x"]}
$ jq -c '.[] | select((.blocked | length) > 0)' b.json
{"id":2,"blocked":["x"]}
数値も同じで、select(.rank) は 0 を通す。値と比べる式なら、無い項目は通らない側に倒れる。
$ echo '[{"id":1},{"id":2,"rank":0},{"id":3,"rank":1}]' > r.json
$ jq -c '.[] | select(.rank)' r.json
{"id":2,"rank":0}
{"id":3,"rank":1}
$ jq -c '.[] | select(.rank > 0)' r.json
{"id":3,"rank":1}
PITFALL: 例えば、あるコマンドの JSON 出力から waiting が false の項目だけを選んで削除するスクリプトを select(.waiting | not) で書くと、コマンドの更新で waiting キーが無くなったときに全項目が削除の対象になる。select(.waiting == false) なら 0 件になる。
// は false も右辺に置き換える
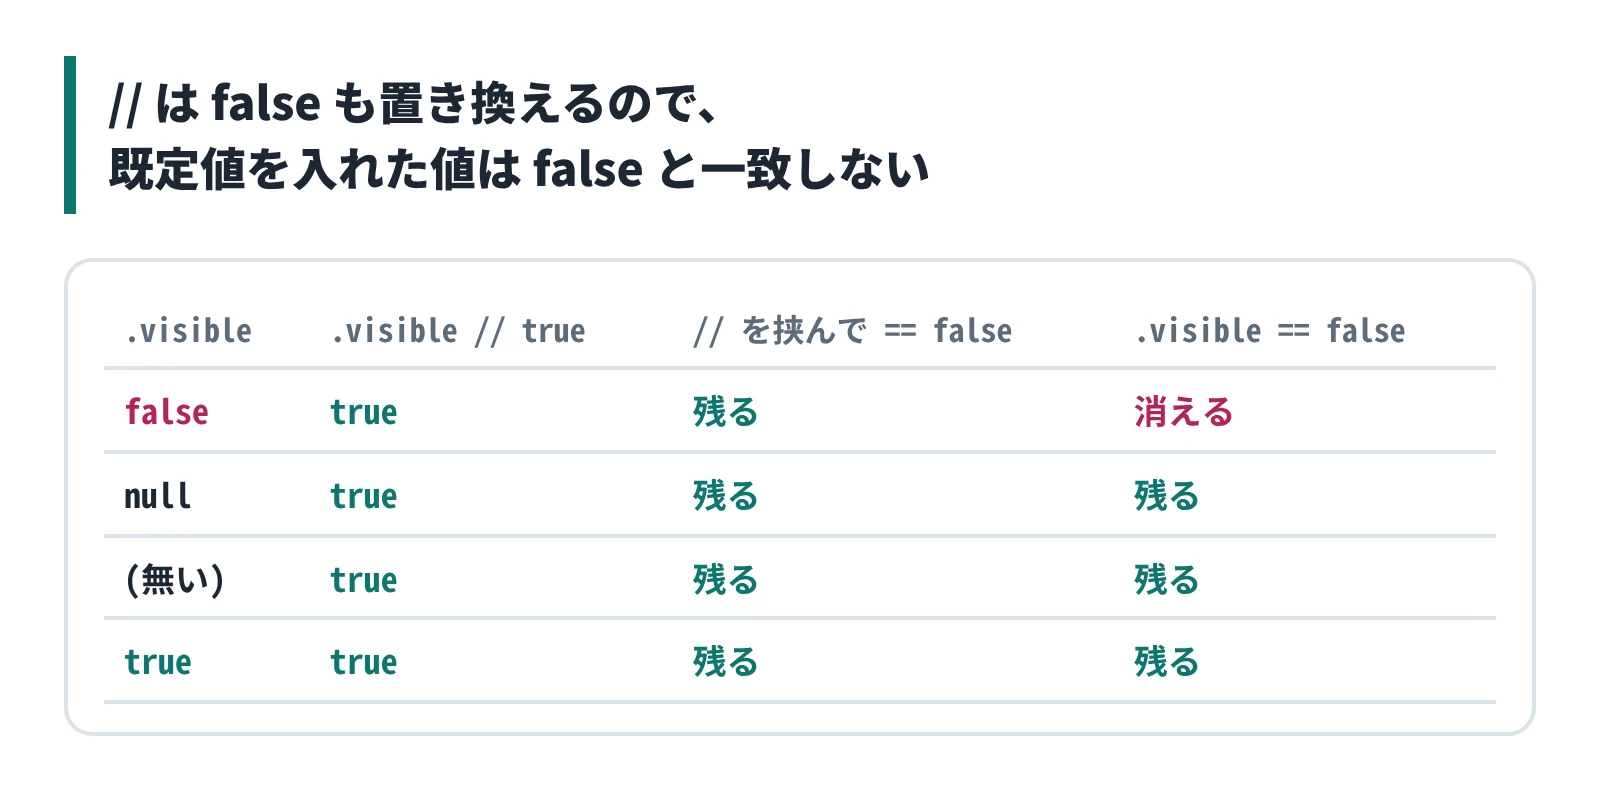
A // B は、A が false または null のときに B を返す。既定値を入れる用途で使うと false まで既定値に置き換わるので、その結果を false と比べる式は成立しない。
$ echo '[{"id":1,"visible":false},{"id":2,"visible":null},{"id":3},{"id":4,"visible":true}]' > n.json
$ jq -c '.[] | {id, v: (.visible // true)}' n.json
{"id":1,"v":true}
{"id":2,"v":true}
{"id":3,"v":true}
{"id":4,"v":true}
$ jq -c '.[] | if (.visible // true) == false then empty else .id end' n.json
1
2
3
4
$ jq -c '.[] | if .visible == false then empty else .id end' n.json
2
3
4
null や無い項目を「指定なし」として扱うなら、// を挟まずに .visible == false と比べる。
PITFALL: 既定値の補完と、その値との比較は別の式にする。
recurse はリーフで止まり、祖先の条件は 2 引数で子孫へ効かせる
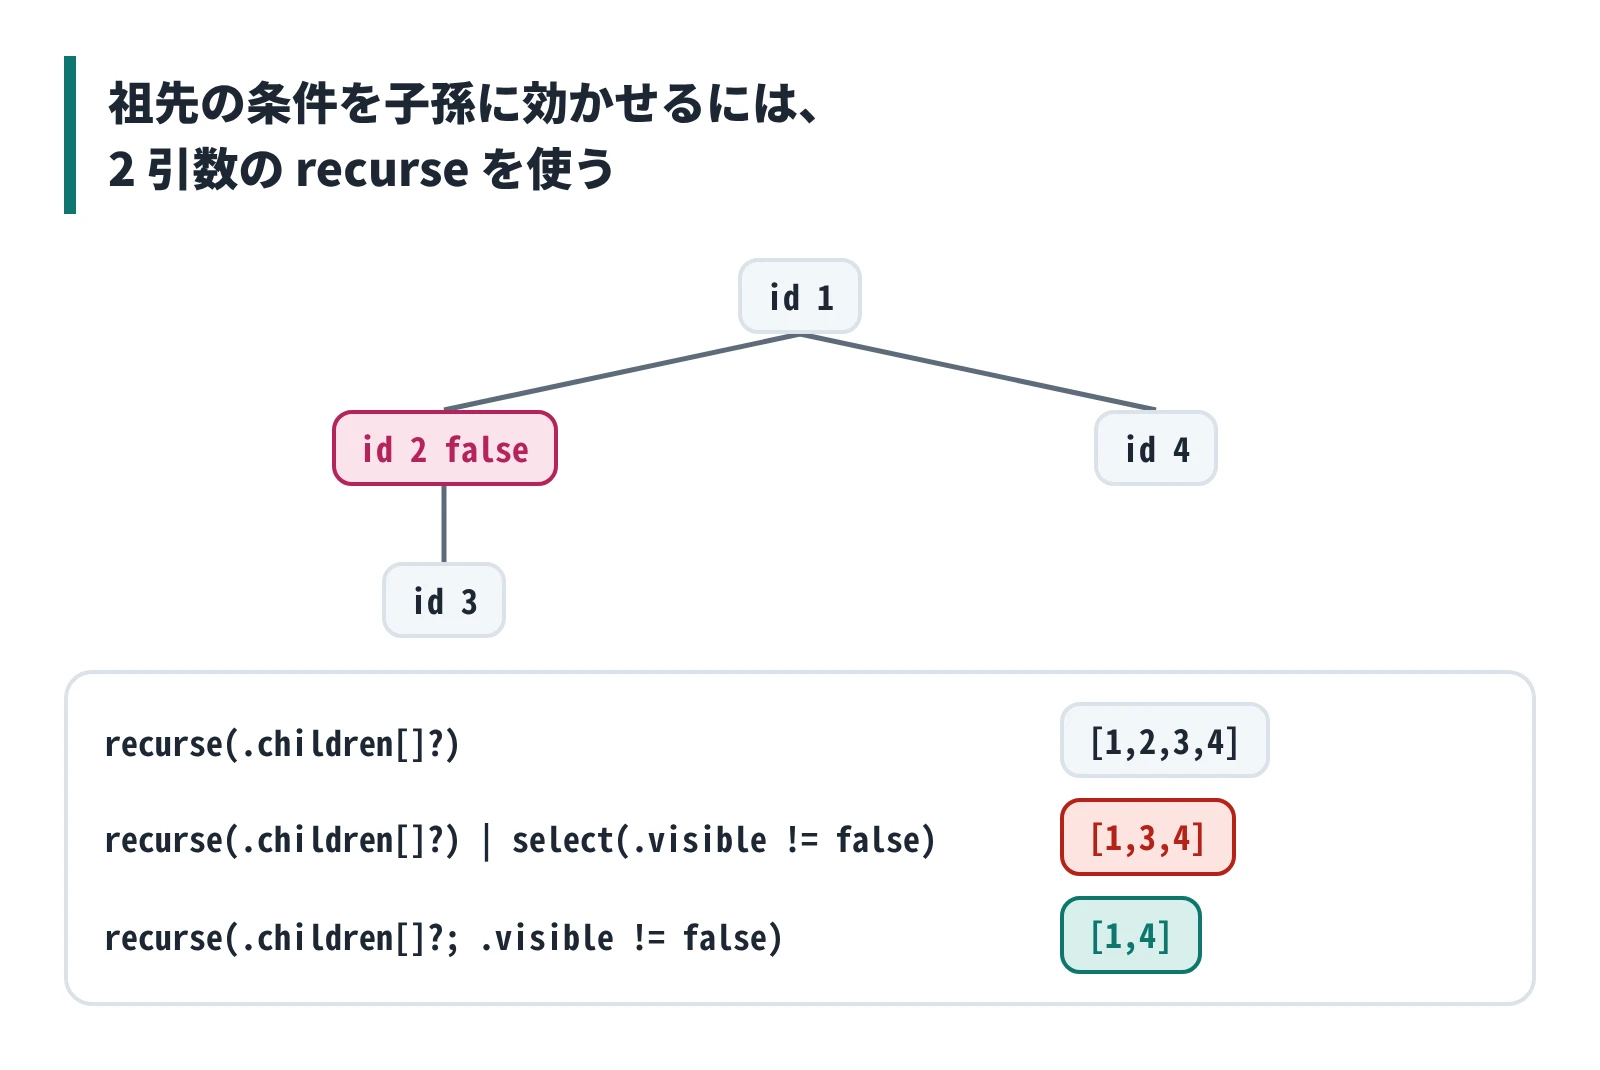
.[] は最上位の配列しか回らないので、.[] | select(...) でツリーを絞ると子の要素が対象から外れ、エラーにもならない。ツリーを辿るには recurse を使う。recurse(f) は今の値を出力し、式 f が返す値 (次に辿る先) のそれぞれに同じことを繰り返す。ただし recurse(.children[]) は、children の無いリーフ (子を持たないノード) で null を回そうとしてエラーで止まる。? は直前の式のエラーを捨てて何も出さない記号なので、付けるとリーフで辿る先が無くなり、そこで終わる。
$ echo '[{"id":1,"children":[{"id":2}]}]' > t.json
$ jq -c '.[] | recurse(.children[])' t.json; echo "rc=$?"
jq: error (at t.json:1): Cannot iterate over null (null)
{"id":1,"children":[{"id":2}]}
{"id":2}
rc=5
$ jq -c '.[] | recurse(.children[]?)' t.json; echo "rc=$?"
{"id":1,"children":[{"id":2}]}
{"id":2}
rc=0
$ jq -c '.[] | select(.id == 2)' t.json; echo "rc=$?"
rc=0
$ jq -c '.[] | recurse(.children[]?) | select(.id == 2)' t.json; echo "rc=$?"
{"id":2}
rc=0
「親が非表示なら子も出さない」は後段の select では書けない。select は各ノード自身の値しか見ないので、visible を持たない子が残る。第 2 引数の cond が真の子だけを辿る recurse(f; cond) なら、偽の子とその子孫が丸ごと消える。
$ echo '{"id":1,"children":[{"id":2,"visible":false,"children":[{"id":3}]},{"id":4}]}' > v.json
$ jq -c '[recurse(.children[]?) | .id]' v.json
[1,2,3,4]
$ jq -c '[recurse(.children[]?) | select(.visible != false) | .id]' v.json
[1,3,4]
$ jq -c '[recurse(.children[]?; .visible != false) | .id]' v.json
[1,4]
cond を当てるのは子に対してだけで、ルート (最上位のノード) は条件が偽でも出力され、その子も辿られる。
$ echo '{"id":1,"visible":false,"children":[{"id":2}]}' | jq -c '[recurse(.children[]?; .visible != false) | .id]'
[1,2]
PITFALL: ルートの条件も効かせるなら、recurse の前に select を置く。
@tsv は \ も二重にするので、JSON を列に詰めると値が変わる
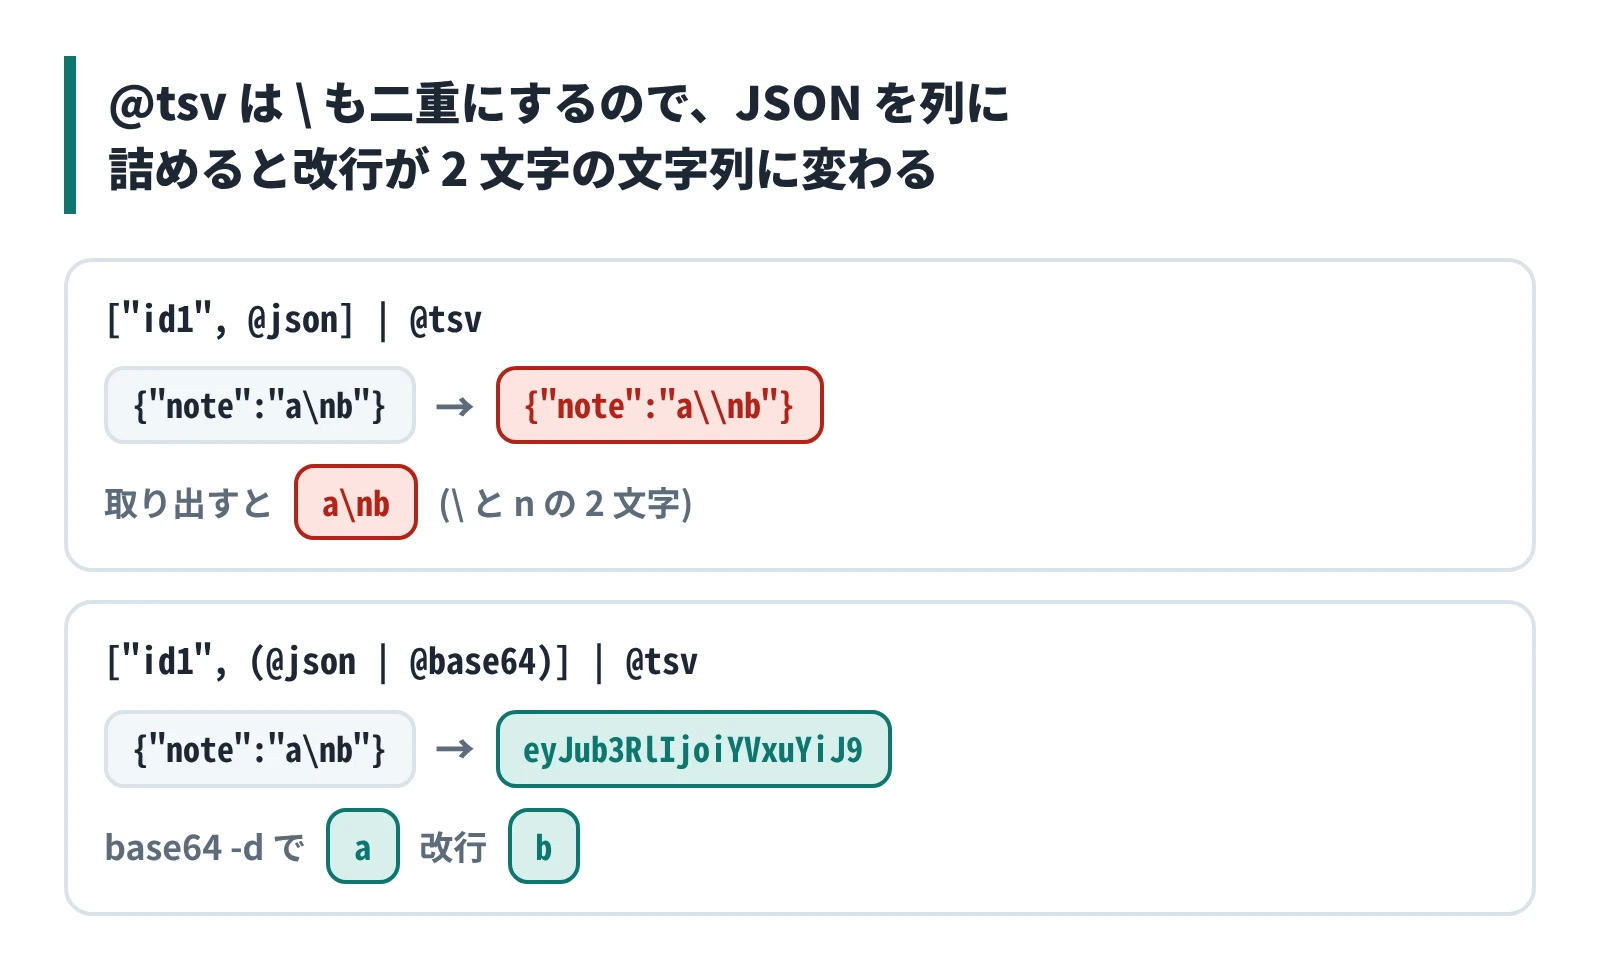
@tsv は 1 行に収めるために、改行とタブを \n と \t の 2 文字にし、\ 自身も \\ にする。先に @json で文字列にした JSON の中には \n の 2 文字があるので、@tsv がその \ を二重にする。取り出した JSON の note は、改行ではなく \ と n の 2 文字になる。
$ jq -rn '["a\nb", "c\td"] | @tsv'
a\nb	c\td
$ jq -rn '{note: "a\nb"} | ["id1", @json] | @tsv' > t.tsv
$ cat t.tsv
id1	{"note":"a\\nb"}
$ cut -f2 t.tsv | jq -r .note
a\nb
TSV の 1 列に JSON を載せて後段へ渡すなら、列の中身を base64 で包む。@base64 の出力に \ は入らないので、@tsv を通っても変わらない。
$ jq -rn '{note: "a\nb"} | ["id1", (@json | @base64)] | @tsv' > b.tsv
$ cat b.tsv
id1	eyJub3RlIjoiYVxuYiJ9
$ cut -f2 b.tsv | base64 -d | jq -r .note
a
b
PITFALL: \n を含まない値では壊れないので、短いテストデータでは気づかない。
@tsv の空の列は IFS=$'\t' read で詰められる
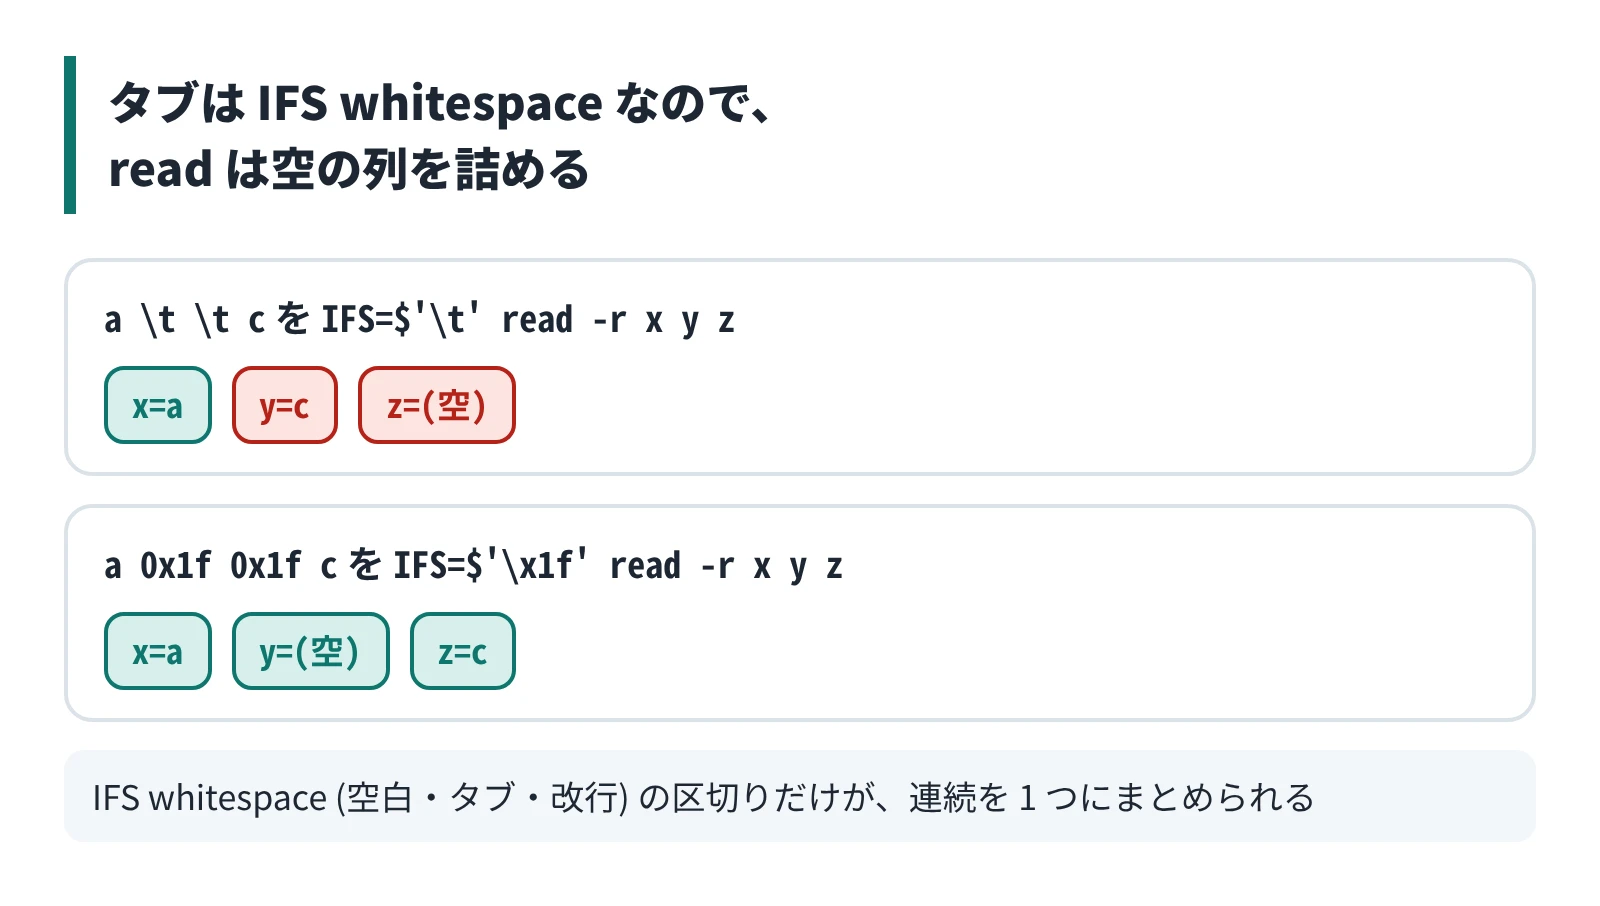
@tsv は空の列も \t\t として出す。列がずれるのは読む側で、タブは IFS whitespace (IFS に入っている空白・タブ・改行のことで、連続を 1 つの区切りにまとめる) に当たるので、read は連続するタブを 1 つの区切りとして扱い、先頭のタブも捨てる。エラーにはならず、隣の列の値が入る。
$ jq -rn '["a", "", "c"] | @tsv' | od -c | head -1
0000000   a  \t  \t   c  \n
$ jq -rn '["a", "", "c"] | @tsv' | { IFS=$'\t' read -r x y z; echo "x=[$x] y=[$y] z=[$z]"; }
x=[a] y=[c] z=[]
$ jq -rn '["", "b", "c"] | @tsv' | { IFS=$'\t' read -r x y z; echo "x=[$x] y=[$y] z=[$z]"; }
x=[b] y=[c] z=[]
空の列を保つなら、awk で読むか、区切りを IFS whitespace でない文字 (ここでは制御文字の 0x1f) に変える。join は @tsv と違って値をエスケープしないので、値に区切り文字が入らないことが前提になる。
$ jq -rn '["", "b", "c"] | @tsv' | awk -F'\t' '{print "x=[" $1 "] y=[" $2 "] z=[" $3 "]"}'
x=[] y=[b] z=[c]
$ jq -rn '["a", "", "c"] | join("\u001f")' | { IFS=$'\x1f' read -r x y z; echo "x=[$x] y=[$y] z=[$z]"; }
x=[a] y=[] z=[c]
$ jq -rn '["", "b", "c"] | join("\u001f")' | { IFS=$'\x1f' read -r x y z; echo "x=[$x] y=[$y] z=[$z]"; }
x=[] y=[b] z=[c]
PITFALL: 全部の列が埋まっているテストでは気づかない。
任意のテキストを JSON の文字列にするなら -R -s
-R は入力を生のテキストとして読み、-s は全体を 1 つの値にまとめる。組み合わせると、stdin 全体が 1 つの JSON 文字列になり、改行は \n、\ は \\ にエスケープされる。シェルの変数を手で JSON に埋め込むより壊れない。末尾の改行も本文に残るので、rtrimstr("\n") で落とす。
$ printf 'x\ny\n' | jq -Rs .
"x\ny\n"
$ printf '*bold* line1\nback\\slash\n日本語\n' | jq -Rsc --arg color good 'rtrimstr("\n") as $m | [{$color, text: $m}]'
[{"color":"good","text":"*bold* line1\nback\\slash\n日本語"}]
変数をキーと値にする略記は {$color} で、$ の無い {color} は .color の略記になる。入力が文字列のときは .color を読めずに落ちる。
$ printf 'x\n' | jq -Rs --arg color good '{color}'; echo "rc=$?"
jq: error (at <stdin>:1): Cannot index string with string ("color")
rc=5
--arg の値は 1 個 128 KiB までしか渡せない
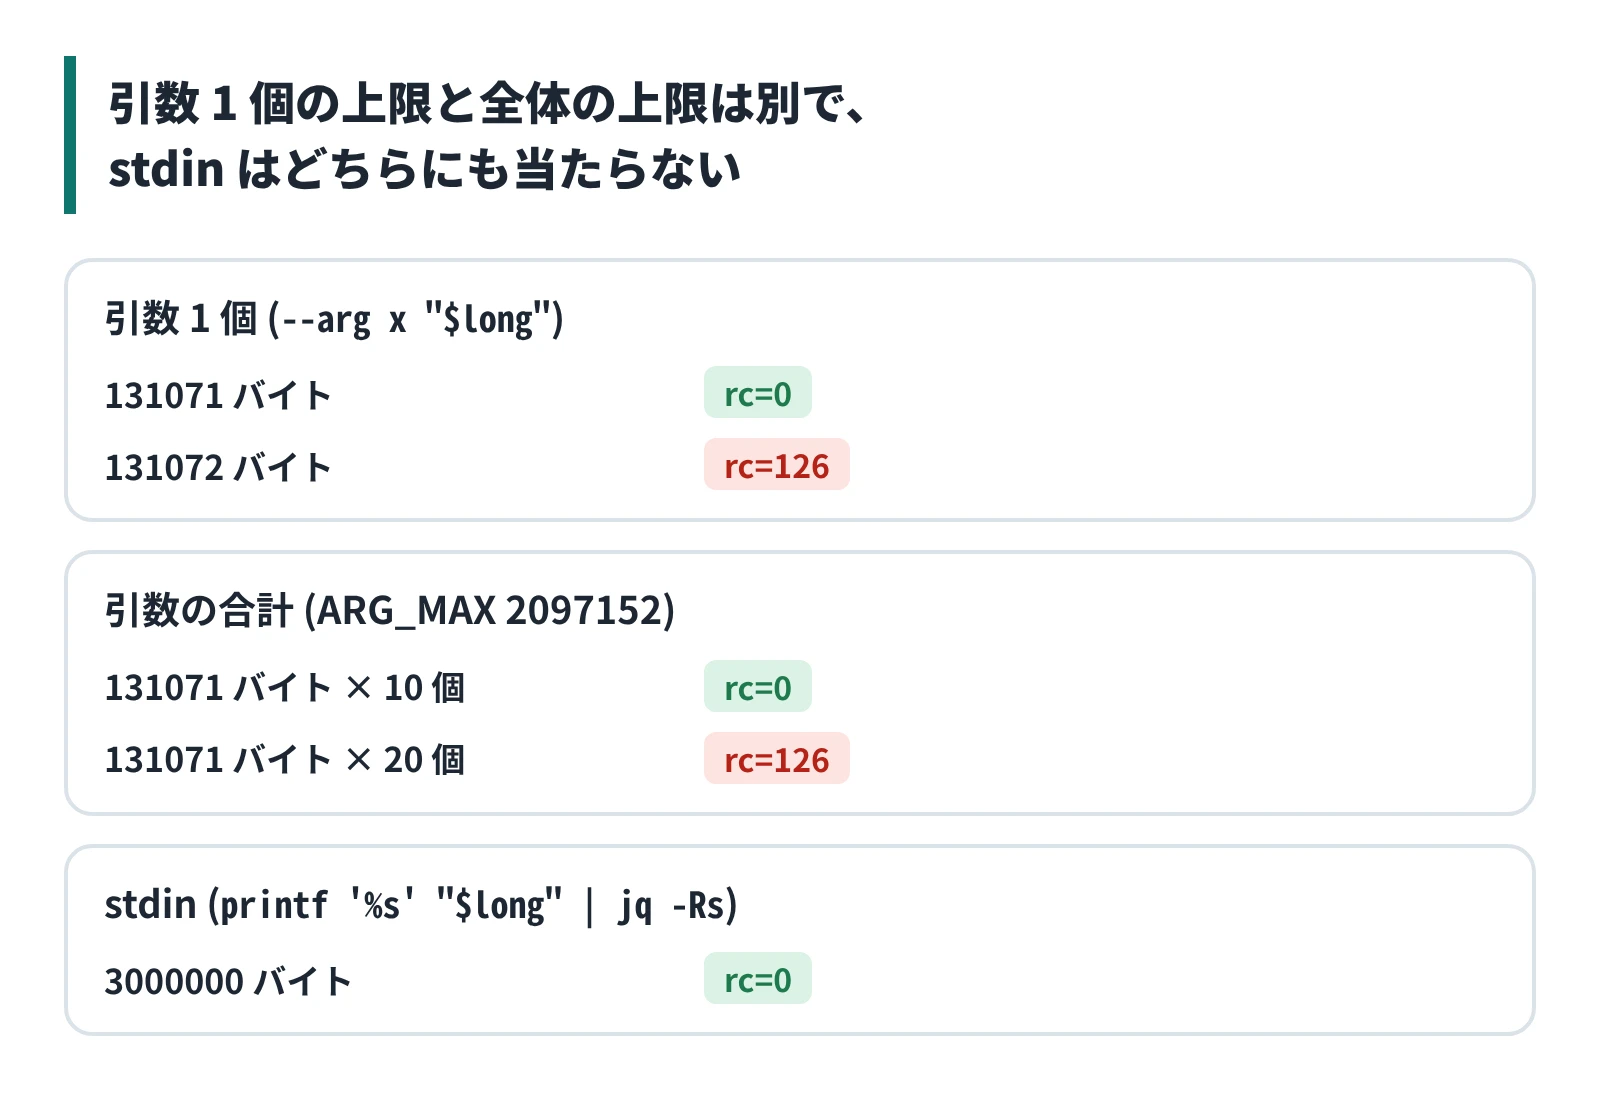
--arg 名前 値 は、シェルの値を jq の変数 $名前 に渡すオプションである。値はコマンドライン引数なので、jq を起動する exec の上限に当たる。Linux の上限は 2 つあり、引数 1 個は MAX_ARG_STRLEN (ページサイズ 4096 の環境では 131072 バイト、終端の NUL を含む)、引数と環境変数の合計は getconf ARG_MAX (手元では 2097152) までに制限される。超えると exec が E2BIG で失敗し、シェルは終了コード 126 を返す。jq は起動しないので、エラー文は bash が出している。
$ getconf ARG_MAX
2097152
$ long=$(head -c 131071 /dev/zero | tr '\0' a); jq -n --arg x "$long" '$x | length'; echo "rc=$?"
131071
rc=0
$ long=$(head -c 131072 /dev/zero | tr '\0' a); jq -n --arg x "$long" '$x | length'; echo "rc=$?"
bash: line 1: /usr/bin/jq: Argument list too long
rc=126
先に当たるのはたいてい 1 個の上限のほうで、合計が 2 MB に届かなくても落ちる。grep -n や git diff の出力を --arg に渡す処理は、minify された JS や 1 行の JSON が混ざると、1 個の引数がこの上限を超える。合計の上限は、131071 バイトの引数を 10 個なら通り、20 個 (約 2.6 MB) で落ちる。
$ long=$(head -c 131071 /dev/zero | tr '\0' a); args=(); for i in $(seq 10); do args+=("$long"); done; jq -n '$ARGS.positional | length' --args "${args[@]}"; echo "rc=$?"
10
rc=0
$ long=$(head -c 131071 /dev/zero | tr '\0' a); args=(); for i in $(seq 20); do args+=("$long"); done; jq -n '$ARGS.positional | length' --args "${args[@]}"; echo "rc=$?"
bash: line 1: /usr/bin/jq: Argument list too long
rc=126
長い値は stdin で渡す。printf は bash の組み込みコマンドで exec を通らないので、この上限に当たらない。cut -c1-200 のように行の長さを切っておく方法もある。
$ long=$(head -c 3000000 /dev/zero | tr '\0' a); printf '%s' "$long" | jq -Rs 'length'; echo "rc=$?"
3000000
rc=0
PITFALL: 例えば git diff の出力を --arg で JSON に入れて検査ツールへ送るスクリプトが jq の終了コードを見ずに次へ進むと、差分が上限を超えたときだけ、検査ツールに何も送られないまま成功として終わる。
1 件ごとに jq を起動すると、jq 1 回で全件を出す形より桁で遅い
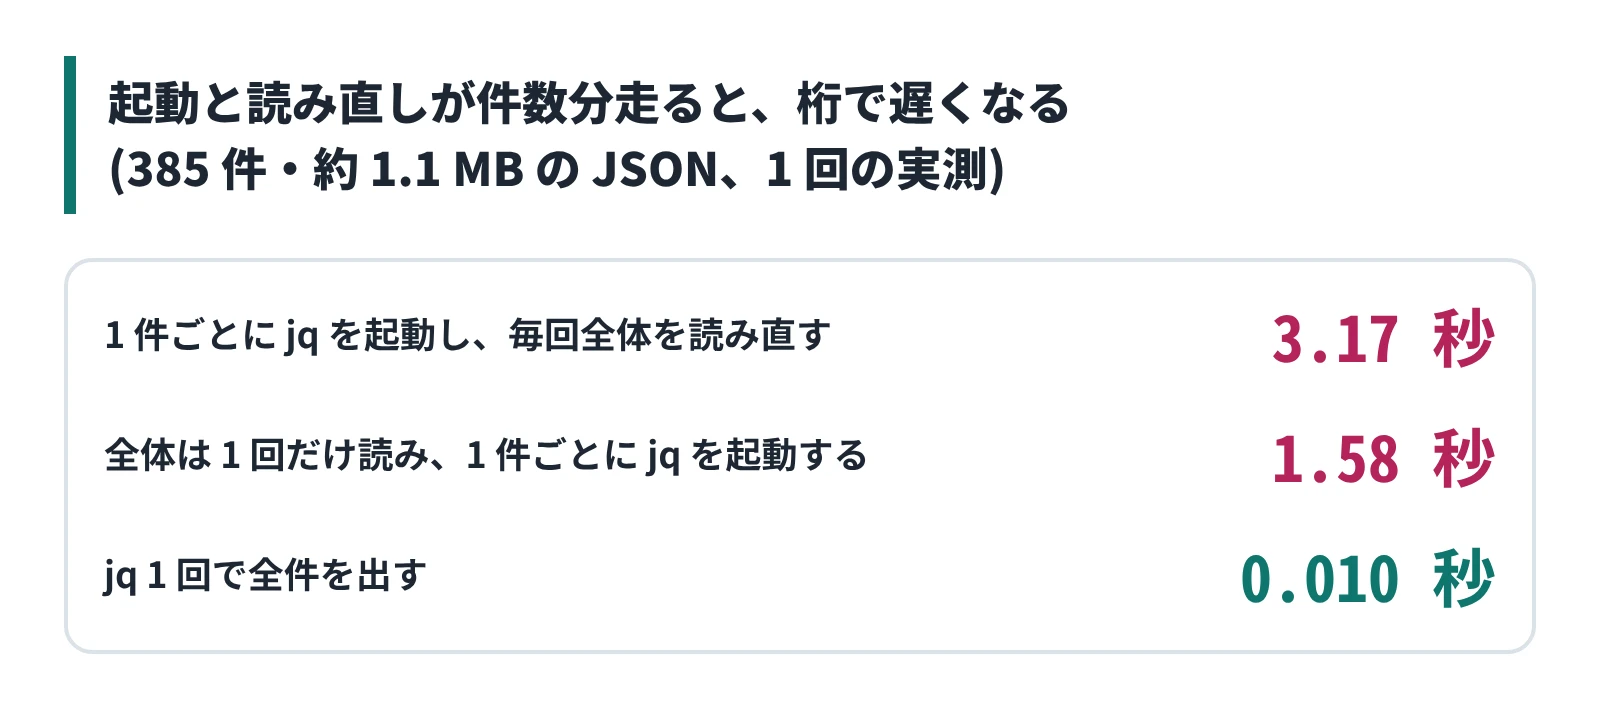
シェルのループの中で jq を起動すると、1 回ごとにプロセスの起動と入力の解析が走る。385 件・約 1.1 MB の JSON で、形だけを変えて同じ値を出した。
$ wc -c spec.json
1105630 spec.json
$ time (jq -r '.paths | keys[]' spec.json | while read -r p; do jq -r --arg p "$p" '.paths[$p].get.summary | length' spec.json; done > /dev/null)

real	0m3.165s
user	0m2.399s
sys	0m0.770s
$ time (jq -c '.paths | to_entries[]' spec.json | while read -r l; do jq -r '.value.get.summary | length' <<<"$l"; done > /dev/null)

real	0m1.580s
user	0m0.777s
sys	0m0.822s
$ time (jq -r '.paths | to_entries[] | .value.get.summary | length' spec.json > /dev/null)

real	0m0.010s
user	0m0.008s
sys	0m0.002s
| 形 | 時間 (手元の 1 回の実測) |
|---|---|
| 1 件ごとに jq を起動し、毎回全体を読み直す | 3.17 秒 |
| 全体は 1 回だけ読み、1 件ごとに jq を起動する | 1.58 秒 |
| jq 1 回で全件を出す | 0.010 秒 |
ループの中で jq を呼ばず、jq の 1 回の実行で全件分の行を作ってから、シェル側では read するだけにする。
PITFALL: ループを jq 1 回に書き直すと、出力がずれやすい。例えば JSON から API ごとのファイルを生成するスクリプトなら、書き直す前に生成したディレクトリを残し、書き直した後の結果と diff -r old new (ディレクトリの中を再帰的に比べる) で比べて、差分が無いことを確かめる。
まとめ
| トピック | 起きること | 対策 |
|---|---|---|
| 連結した JSON | 値の数だけ結果が出て終了コード 0 | -s で length == 1 と型を確かめる |
| 壊れた箇所の手前 | 手前の値を出して終了コード 5 | 終了コードを見る。-s で全部読んでから使う |
| JSON Lines の破損 | -s は何も出さない | -R と fromjson? |
| 真偽 | 偽は false と null だけ | == false、> 0、length で比べる |
// | false も右辺に置き換わる | 既定値の補完と比較を分ける |
recurse(.children[]) | children の無いリーフで止まる | recurse(.children[]?) |
| 祖先の条件 | 後段の select では子孫が残る | recurse(f; cond)。ルートは別に絞る |
@tsv に JSON | \ が二重になり値が変わる | @base64 で包む |
IFS=$'\t' read | 空の列が詰められて列がずれる | awk で読むか、IFS whitespace でない区切りにする |
| テキストの埋め込み | 手で埋めると壊れる | -R -s、{$name}、rtrimstr("\n") |
--arg の長さ | 1 個 128 KiB を超えると終了コード 126 | 長い値は stdin で渡す |
| ループ内の jq | 起動と解析が件数分走る | jq 1 回で全件を出す |